Si trabajas con microservicios, seguro te has hecho esta pregunta: “¿qué servicio ya hace esto?”. La respuesta existe, escrita en los contratos OpenAPI, pero nadie la encuentra a tiempo. Se termina preguntando por chat a quien “sabe”, esperando, y a veces creando un endpoint que ya existía.
Quise probar si un sistema RAG podía responder esa pregunta en lenguaje natural, con tres condiciones que no son negociables cuando hay datos sensibles de por medio:
- Nada sale de la máquina: modelos locales, sin APIs externas.
- Cada quien ve solo lo que le corresponde: permisos aplicados antes de que el modelo vea nada.
- Todo queda trazado, sin guardar lo que escribió el usuario.
El resultado es una demo pequeña: un archivo de Python, tres dependencias y un corpus 100 % sintético. Aquí explico los conceptos, la arquitectura, las decisiones de diseño y, sobre todo, lo que aprendí cuando la puse a prueba.
El código completo está en github.com/PalaciosLuisMig/demo-rag-local.
Los conceptos en pocos minutos (con analogías)
-
LLM (Large Language Model): Es un practicante brillante en su primer día: leyó casi todo internet y redacta muy bien, pero nunca entró a tu empresa. Si no sabe algo, no dice “no sé”: improvisa con total seguridad.
-
Alucinación: Es el practicante que, en vez de admitir que no sabe, inventa una respuesta con aplomo. El texto suena correcto y bien redactado, pero el dato no existe: un endpoint que nadie creó, un servicio con nombre verosímil. En un catálogo de microservicios es peligroso, porque nadie sospecha de una respuesta tan segura. Se reduce dándole al modelo fuentes reales y la instrucción de decir “no lo encuentro” cuando no las tiene.
-
RAG (Retrieval-Augmented Generation): Es un examen a libro abierto. En vez de pedirle al modelo que responda de memoria, primero se buscan las páginas correctas, se ponen sobre el escritorio y el modelo responde citando la fuente. Si cambia un contrato, no se reentrena nada: solo se vuelve a indexar. Los tres conceptos siguientes son los pasos para dejar esas páginas listas para buscar.
-
Chunking: Es la forma de cortar los documentos en fichas antes de indexarlos. Cortar cada 600 caracteres es como usar una tijera a ciegas: una ficha termina a mitad de un endpoint y la siguiente no sabe de qué servicio es. Cortar por estructura produce fichas que se entienden solas.
-
Embeddings: Son coordenadas GPS del significado. Un modelo convierte cada ficha en un vector, una lista de números. Los textos que significan lo mismo quedan en el mismo barrio del mapa aunque usen palabras distintas: “pagar la luz” y “recaudación de servicios básicos” quedan a una cuadra. Por eso esta búsqueda encuentra cosas que un
LIKE '%luz%'jamás encontraría. -
Vector: Es la dirección de una ficha en ese mapa: una lista de números, una coordenada por dimensión. Un modelo como
bge-m3produce vectores de 1024 dimensiones, así que cada ficha es un punto en un espacio de 1024 ejes. Dos fichas cercanas en ese espacio significan algo parecido, y “cercanía” se mide con una distancia (más sobre esto en la sección de métricas). La pregunta del usuario también se convierte en vector, y buscar es encontrar los puntos más próximos al suyo. -
Vector store: Es un bibliotecario que no ordena por orden alfabético sino por tema. Aquí se guarda cada vector junto con su texto y sus metadatos. Le describes lo que buscas y te trae los libros más cercanos, gracias a índices como HNSW (Hierarchical Navigable Small World). HNSW es como buscar una dirección en otro país: avión a la ciudad, taxi al barrio y a pie hasta la casa, en lugar de recorrer todas las casas una por una.
La arquitectura RAG local sobre un catálogo de microservicios
| Pieza | Herramienta | Para qué |
|---|---|---|
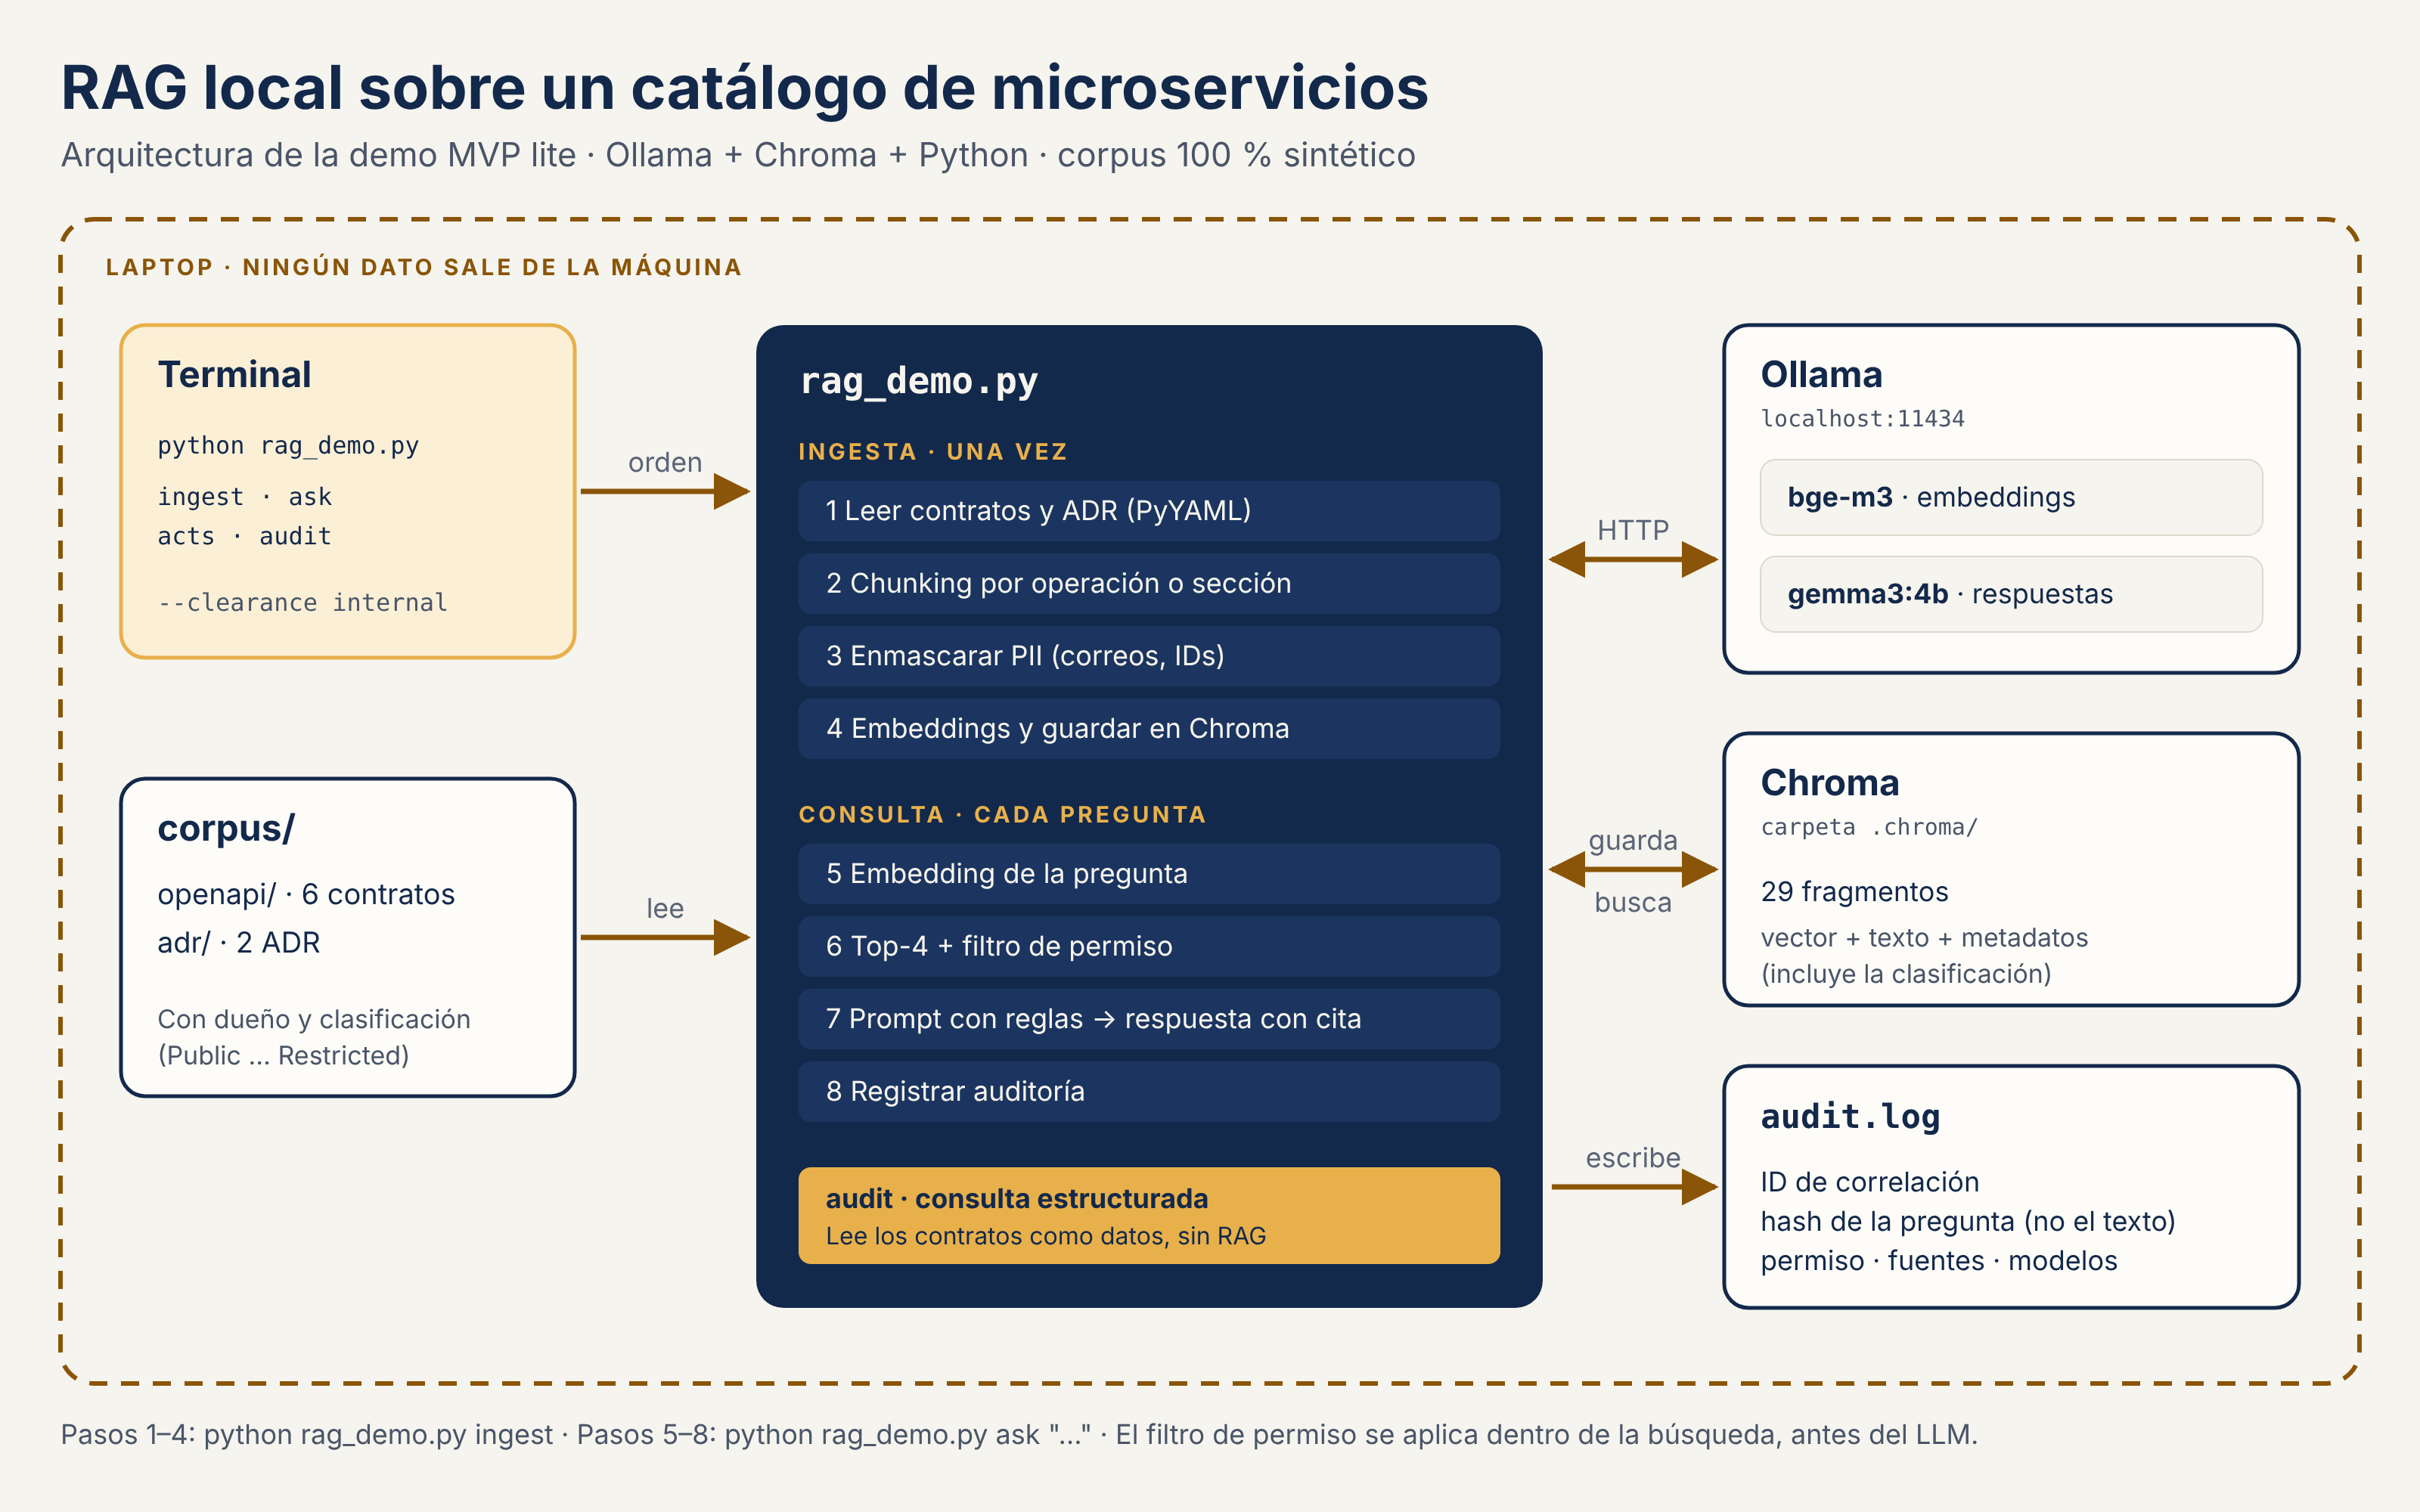
| Modelos locales | Ollama | Sirve bge-m3 (embeddings multilingües) y gemma3:4b (respuestas) en localhost:11434. |
| Vector store | Chroma | Base embebida que guarda en una carpeta local (.chroma/). |
| Lectura de contratos | PyYAML | Convierte cada OpenAPI en un diccionario de Python. |
| Orquestación | Python, sin frameworks | Un solo archivo donde se ve cada paso. |
Todo el sistema son dos flujos:
- Ingesta (una vez): leer 6 contratos OpenAPI y 2 ADR, cortarlos en fichas, enmascarar datos personales, generar embeddings y guardarlos. Resultado: 29 fragmentos.
- Consulta (cada pregunta): convertir la pregunta en vector, traer los 4 fragmentos más cercanos que el usuario tiene permiso de ver, armar un prompt con reglas, generar la respuesta con su cita y registrar la auditoría.
Dejé LangChain fuera a propósito. Para aprender, prefiero ver cada paso; el framework llega cuando el problema lo pide.
Cuatro decisiones de diseño
1. Chunking por operación, no por caracteres
Cada operación OpenAPI (método + ruta) es una ficha, y cada ficha lleva su propio contexto: servicio, versión, dueño, clasificación, parámetros y si exige Idempotency-Key. Los ADR se cortan por sección. Así un contrato nunca queda partido por la mitad.
lines = [
    f"Microservicio: {service} (versión {info['version']})",
    f"Contexto: {info['x-bounded-context']} | "
    f"Dueño: {info['x-owner']} | Clasificación: {classification}",
    f"Operación: {method.upper()} {path}",
    f"Resumen: {operation['summary']}",
    f"Descripción: {operation['description']}",
    f"Parámetros: {params or 'ninguno'}",
    f"Idempotency-Key: {'requerido' if has_key else 'no declarado'}",
]
No es solo intuición: un estudio sobre chunking de especificaciones OpenAPI para RAG encontró que los métodos específicos del formato superan al corte ingenuo (Pesl et al., 2024).
2. Datos personales enmascarados antes de indexar
Si un dato personal entra al índice, puede terminar en una respuesta. Por eso el enmascarado corre antes de los embeddings:
PII_PATTERNS = (
    ("EMAIL", re.compile(r"[\w.+-]+@[\w-]+(?:\.[\w-]+)+")),
    ("NUMERIC_ID", re.compile(r"\b\d{9,13}\b")),
)
En el corpus de prueba se enmascaran 4 valores: dos correos, una cédula y un celular, todos ficticios. Hay tests que lo verifican.
3. Permisos dentro de la búsqueda, no en el prompt
Cada contrato declara su clasificación (Public, Internal, Confidential o Restricted) en sus metadatos. El filtro se aplica en la consulta al vector store:
result = collection.query(
    query_embeddings=embed([question]),
    n_results=TOP_K,
    # El filtro de permisos se aplica dentro de la consulta, antes de generar.
    where={"classification_rank": {"$lte": CLASSIFICATION_RANK[clearance]}},
)
Con --clearance internal, los contratos Restricted y Confidential ni siquiera son candidatos. Esto importa porque pedirle al LLM que “no muestre” algo no es un control de seguridad: si el fragmento ya llegó al contexto, una pregunta ingeniosa puede sacarlo. El LLM nunca decide quién ve qué; lo decide el filtro.
4. Auditoría con hash, no con texto
Cada pregunta deja un registro en audit.log con un ID de correlación, el permiso aplicado, los fragmentos recuperados y los modelos usados. La pregunta no se guarda; solo un hash:
{"correlation_id": "e105440a1bf440559eda4e0b295fefc1",
 "question_sha256": "8b97b0ce6980f886",
 "clearance": "restricted",
 "retrieved": ["accounts-service GET /api/v1/accounts/{accountId}/balance", "..."],
 "chat_model": "gemma3:4b", "embed_model": "bge-m3"}
Para la demo, el hash basta: queda constancia de que se hizo una consulta, con qué permisos y qué fragmentos se usaron, sin guardar lo que escribió la persona. En producción sí podrías guardar la pregunta completa, por ejemplo para depurar respuestas malas o armar un set de evaluación. Eso exige controles: enmascarar datos personales antes de guardarla, restringir quién puede leer el registro, cifrarlo y definir cuánto tiempo se conserva.
Si decides no guardarla, usa un HMAC en lugar de un hash simple. Las preguntas suelen ser cortas y previsibles (“¿qué servicio expone el saldo?”), y con un hash simple cualquiera que sospeche una pregunta puede calcular su hash y compararlo con el registro. El HMAC mezcla la pregunta con una clave secreta guardada en un gestor de secretos, y sin esa clave nadie puede hacer esa comprobación.
Tres preguntas, tres lecciones
Probé la demo con tres preguntas elegidas a propósito. Los números son los resultados reales del ensayo.
Acto 1: encuentra y cita
¿Qué microservicio expone la consulta de saldo de una cuenta?
Respondió accounts-service GET /api/v1/accounts/{accountId}/balance, con la fuente citada. El fragmento correcto quedó a una distancia de 0.550, claramente separado del segundo (0.778). Esa brecha es buena señal: el sistema no duda.
Acto 2: sabe decir “no sé”
¿Qué microservicio permite cambiar el PIN de una tarjeta?
No existe ninguna operación de PIN en el catálogo, y la respuesta fue “No lo encuentro en el catálogo.”. Recuperó fichas de tarjetas porque eran lo más parecido, pero todas lejos (0.94 a 1.03), y el prompt obliga a no inventar. En un sistema así, decir “no sé” es una funcionalidad, no un fallo.
Acto 3: RAG encuentra, no cuenta
¿Qué microservicios NO exigen Idempotency-Key en sus POST?
El RAG falló: respondió “No lo encuentro en el catálogo.”. Trajo 4 POST que sí exigen la clave, porque la pregunta menciona “POST” e “Idempotency-Key” y el “NO” casi no cambia el embedding.
Una consulta estructurada sobre los mismos contratos (python rag_demo.py audit) da la respuesta exacta: unblockCard y sendNotification.
Esta es la lección que más me sirvió como arquitecto:
Si la pregunta suena a SQL (contar, listar todos, “cuáles NO”), no es trabajo de RAG.
RAG trae los fragmentos más parecidos; no recorre todo el catálogo ni garantiza una lista completa. Para “¿dónde está?” sirve la búsqueda semántica; para “¿cuántos?” o “¿cuáles no?” sirve una consulta determinística. El paso natural siguiente es un agente que elija la herramienta según la pregunta. Lo bueno es que, aun fallando, el sistema no inventó una lista falsa.
Un detalle sobre métricas: euclidiana vs coseno
Los números de los tres actos (0.550, 0.778, 0.94 a 1.03) son distancias: cuanto más bajo, más cerca está la ficha de la pregunta. La demo usa “distancia L2”, que es la métrica por defecto de Chroma. En búsqueda semántica es más común hablar de similitud del coseno. Son dos formas distintas de medir qué tan cerca están dos vectores:
| Métrica | Qué mide | Analogía |
|---|---|---|
| Euclidiana (L2) | La distancia en línea recta entre dos puntos. | Dos ciudades en el mapa: cuántos kilómetros las separan. |
| Coseno | El ángulo entre dos vectores, sin importar su longitud. | Dos personas señalando: ¿apuntan hacia el mismo lado? |
Si los vectores están normalizados (longitud 1), ambas métricas ordenan los resultados igual, porque d² = 2 − 2·cos θ. Para dos vectores iguales la distancia es 0 y a medida que se alejan crece, así que el ranking de la demo no cambiaría con coseno.
Si tu modelo no garantiza vectores normalizados, la longitud empieza a influir en la distancia L2 y el orden puede variar. En ese caso, o normalizas los vectores antes de guardarlos, o configuras la colección con distancia coseno de forma explícita:
collection = client.get_or_create_collection(
    name="catalogo",
    metadata={"hnsw:space": "cosine"},
)
Sea cual sea la métrica, el valor absoluto importa menos que la brecha: en el Acto 1 la distancia de 0.550 contra 0.778 del segundo candidato es lo que dio confianza, y en el Acto 2 todo quedó lejos (0.94 o más) y por eso la respuesta correcta fue “no lo encuentro”.
De demo a producción
La demo ya resuelve en pequeño tres controles (permisos, datos personales y auditoría). Para producción faltan, al menos:
- Fuentes reales y frescas: contratos tomados del repositorio o del API Gateway, y reindexado automático en CI/CD al publicar una versión.
- Permisos desde la identidad corporativa, no desde un flag de línea de comandos.
- Mejor detección de datos personales: las expresiones regulares no detectan nombres. Un nombre completo de ejemplo pasa sin enmascarar. Hace falta detección de entidades o enmascarar por nombre de campo.
- HMAC en la auditoría y un registro central con retención definida.
- Evaluación continua: un set de preguntas de oro escrito por los dueños de cada servicio, que mida si se recuperó el fragmento correcto, si la respuesta se quedó en el contexto y si dijo “no lo encuentro” cuando correspondía.
- Infraestructura para varios usuarios: Ollama es ideal en una laptop; para un servidor compartido con GPU, vLLM ofrece mejor concurrencia.
Pruébalo
Necesitas Python 3.10 o superior y Ollama instalado.
# Modelos
ollama pull bge-m3
ollama pull gemma3:4b

# Entorno
python -m venv .venv
source .venv/bin/activate        # Windows: .\.venv\Scripts\Activate.ps1
pip install -r requirements.txt

# Tests (no necesitan Ollama)
python -m unittest discover -s tests -v

# Indexar y preguntar
python rag_demo.py ingest
python rag_demo.py ask "¿Qué microservicio expone la consulta de saldo de una cuenta?"
python rag_demo.py ask "¿Qué microservicio expone la consulta de saldo de una cuenta?" --clearance internal
python rag_demo.py acts          # los tres actos, con pausa entre cada uno
python rag_demo.py audit         # la consulta estructurada
Código: github.com/PalaciosLuisMig/demo-rag-local
Para cerrar
Lo que más me llevo de este experimento es que las decisiones importantes de un RAG son de arquitectura, no de modelo: cómo cortas los documentos, dónde aplicas los permisos, qué datos dejas entrar al índice y qué preguntas no le corresponden.
¿Qué preguntas de tu día a día crees que un RAG respondería bien, y cuáles suenan más a SQL?