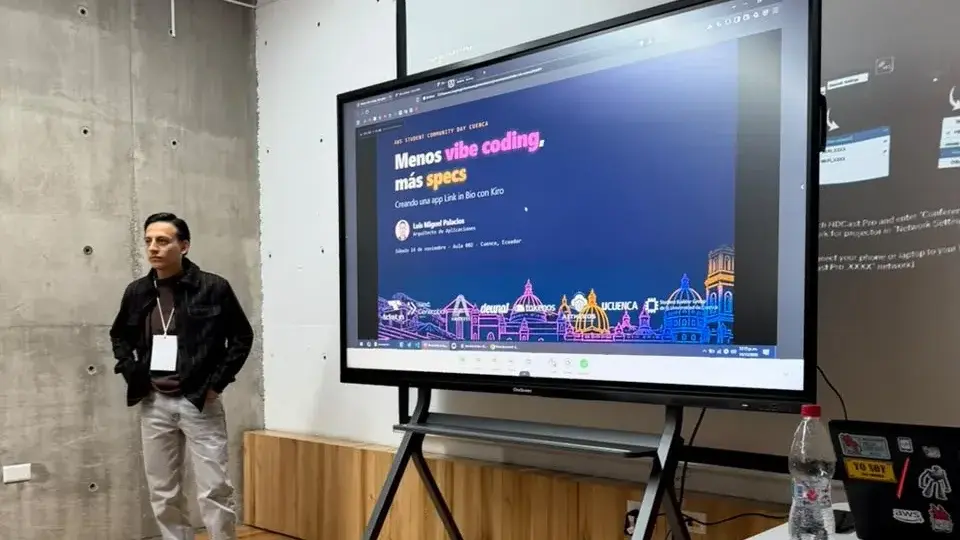
El sábado 14 de noviembre tuve el honor de participar como speaker en el AWS Student Community Day Cuenca, organizado por el AWS Student Builder Group Universidad de Cuenca en el Campus Balzay.
Mi sesión se llamó “Menos vibe coding, más specs: creando una app Link in Bio con Kiro” (Aula 002). Aquí resumo lo más importante de la charla, para quien estuvo y para quien no pudo venir.
El problema: el vibe coding
Vibe coding es describir lo que quieres en lenguaje natural y aceptar lo que genera la IA, iterando “a ojo” hasta que parece funcionar: prompt, código, “¿funciona?”, otro prompt. No lo demonizo: es muy rápido para empezar, ideal para explorar ideas y baja la barrera de entrada.
Lo que se pierde es lo que importa cuando el prototipo crece:
- El “por qué” de cada decisión. Por ejemplo, el límite de peticiones de la demo es global y no por IP porque el público comparte la Wi-Fi. Si eso no está escrito, alguien lo “arregla” y lo rompe.
- Qué está probado y qué no. Sin requisitos no hay contra qué probar.
- El contexto entre sesiones. El chat se olvida; el repositorio no.
El vibe coding te deja el código, pero se lleva el por qué, qué está probado de verdad y el contexto para seguir mañana. Las specs existen para que eso no se pierda.
El cuello de botella ya no es escribir código, es saber qué construir. La IA escribe muy rápido; lo caro es la ambigüedad, porque si no está escrito qué debe hacer el sistema, la IA rellena los huecos inventando.
La alternativa: Spec-Driven Development (SDD)
En SDD la especificación es la fuente de verdad y el código se genera a partir de ella, no al revés:
Requisitos (qué debe hacer) → Diseño (cómo lo hará) → Tareas (en qué orden) → Código + tests
No es volver a la cascada de los 90: cada documento lo genera la IA en minutos, y la diferencia son los puntos de control humanos (human in the loop). Cada paso se revisa y se aprueba antes del siguiente; la IA propone y ejecuta, tú decides.
¿Cuánto vive la spec?
Según Birgitta Böckeler (Thoughtworks) hay tres niveles de SDD, según cuánto se compromete el equipo con la spec:
- Spec-first: la spec se escribe antes del código y guía la tarea actual. Al terminar, puede quedar olvidada.
- Spec-anchored: la spec se conserva y evoluciona con la funcionalidad. Es lo que hicimos en este proyecto: vive versionada en el repo, con una rama por fase.
- Spec-as-source: solo se edita la spec y el código se regenera; nadie lo toca a mano.
Mi consejo: empieza por spec-first y da el paso a spec-anchored dejando la spec en el repo y manteniéndola al día.
Kiro: el IDE agéntico de AWS pensado para specs
Kiro trabaja con specs desde el primer minuto y guarda todo como archivos Markdown y JSON dentro del repo, así que se versionan y se revisan en un PR como el código:
| Pieza | Carpeta | Para qué |
|---|---|---|
| 🧭 Steering | .kiro/steering/ | Contexto permanente: producto, stack y convenciones. |
| 📐 Specs | .kiro/specs/ | Requisitos, diseño y tareas que Kiro genera y ejecuta. |
| 🪝 Hooks | .kiro/hooks/ | Automatismos ante eventos, como lint y tests al guardar. |
Si quieres conocer más sobre la herramienta, escribí antes sobre ella en ¿Ya conoces Kiro?.
El caso real: Link in Bio con métricas en vivo
Para no quedarnos en teoría construimos una app pequeña pero completa: frontend, backend, tiempo real, infraestructura y pruebas de carga.
- Página pública de enlaces, mobile first.
- Panel del propietario en tiempo real: clics por minuto, canal de origen (
?src=) y feed de actividad. - Privacidad por construcción: sin IPs ni cookies.
El proceso fueron 6 fases, 6 ramas del repositorio. Cada rama contiene la fase ya completada, así que puedes replicar cualquiera partiendo de la anterior.
Fase 0 · Steering: “cómo trabajamos aquí”
Tres archivos: product.md (visión, usuarios, privacidad), tech.md (Node.js 24, TypeScript strict, AWS, calidad) y structure.md (monorepo y convenciones). Regla práctica: si una frase se puede escribir como “WHEN… THE SYSTEM SHALL…”, es un requisito y va a la spec, no al steering. Así no hay dos fuentes de verdad que se contradicen.
Fase 1 · Requisitos verificables con EARS
EARS (Easy Approach to Requirements Syntax) usa plantillas fijas y sin ambigüedad. El proyecto tiene 17 requisitos así. Algunos ejemplos reales:
- WHEN un Visitante activa un Enlace, THE Página Pública SHALL llevarlo al destino en máximo 300 ms, sin esperar a la API.
- IF el registro del Clic falla, THEN THE Página Pública SHALL llevar igualmente al Visitante al destino, sin mostrar error.
- THE API de Gestión SHALL NOT escribir el token en los registros de ejecución ni en las respuestas de error.
Fíjate en que todos tienen un número o un caso de fallo, así que se pueden probar. “La página debe ser rápida” no se puede probar. Y la seguridad también se escribe como requisito.
Fase 2 · Diseño: arquitectura serverless y propiedades
Todo vive en un stack de AWS CDK en us-east-1: CloudFront como única entrada pública, S3 privado (OAC), API Gateway HTTP y WebSocket, cuatro Lambdas con permisos mínimos, DynamoDB con tabla única, Parameter Store para el token y DynamoDB Streams para empujar los cambios al panel en tiempo real. Quedaron 17 decisiones documentadas (D1 a D17) y un dominio hexagonal que no sabe nada de AWS.
Del diseño también salen 18 propiedades de corrección para property-based testing: un test normal prueba un ejemplo; uno de propiedades prueba una regla con cientos de entradas aleatorias. Por ejemplo, para cualquier valor de src, normalizar el canal dos veces debe dar lo mismo que hacerlo una vez.
// fast-check: ≥ 100 ejecuciones
fc.assert(
  fc.property(fc.string(), (src) => {
    const once = normalizeChannel(src);
    const twice = normalizeChannel(once);
    expect(twice).toBe(once);
  })
);
Fase 3 · Tareas: de dentro hacia fuera
Primero el motor, después la carrocería: dominio (las reglas, sin AWS, con tests que corren en milisegundos), luego backend, infraestructura y por último frontend. Cada tarea cita los requisitos que cumple (_Requirements: 2.1, 2.2_) y hay puntos de control en las tareas 8, 12 y 17: se para, se comprueba que todo está en verde y solo entonces se sigue. Así un error se detecta en la capa donde nace, no tres capas después. Además, un hook ejecuta npm run lint y npm test al guardar archivos .ts.
Fase 4 · Implementación: Kiro ejecuta, tú revisas
- 812 tests en 50 archivos.
- 17 tareas, un commit por tarea.
- 5,2 KB de página pública comprimida (el límite era 30 KB).
Un truco que recomiendo: la mutación manual. Rompí el código a propósito para comprobar que algún test fallaba, y así aparecieron tests débiles que arreglé. No te fíes de “todos los tests en verde” sin hacerlo.
Fase 5 · Despliegue con CDK y prueba de carga
Un solo stack con 74 recursos, todo de pago por uso: cdk diff para revisar, cdk deploy para crear, npm run smoke para comprobar y cdk destroy para borrar todo al terminar.
Después, una prueba de carga de 500 clics en 10 segundos, y cada número se comprueba contra un criterio EARS:
- 500/500 clics confirmados, con sumas exactas por canal (qr 250 · instagram 125 · tiktok 125).
- 221 ms de p95 de respuesta (requisito: menos de 1 s).
- 762 ms de p95 del clic al panel (requisito: menos de 3 s).
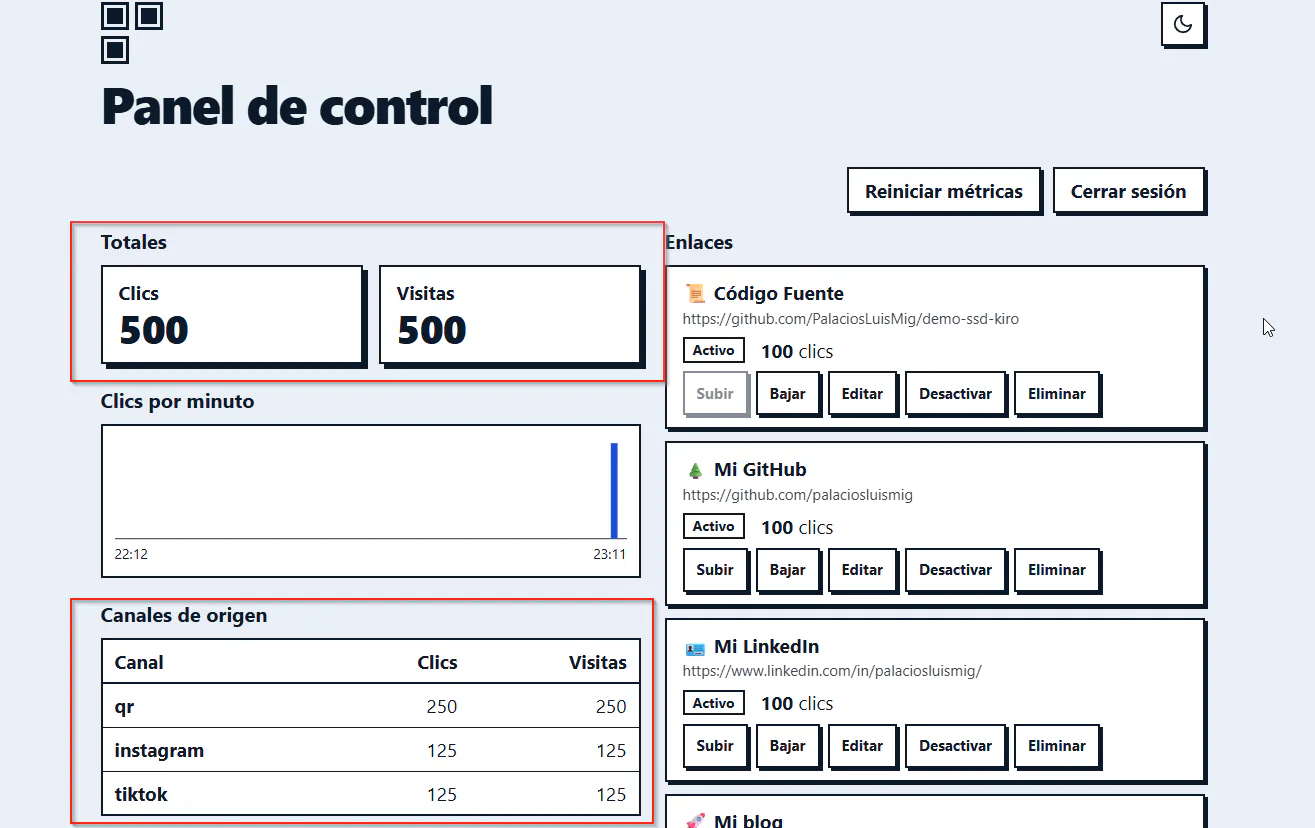
Esto es lo bonito de tener requisitos con números: el resultado no es “va bien”, es “cumple el criterio 12.4 con un p95 de 221 ms”.
La demo en vivo: ahora ustedes
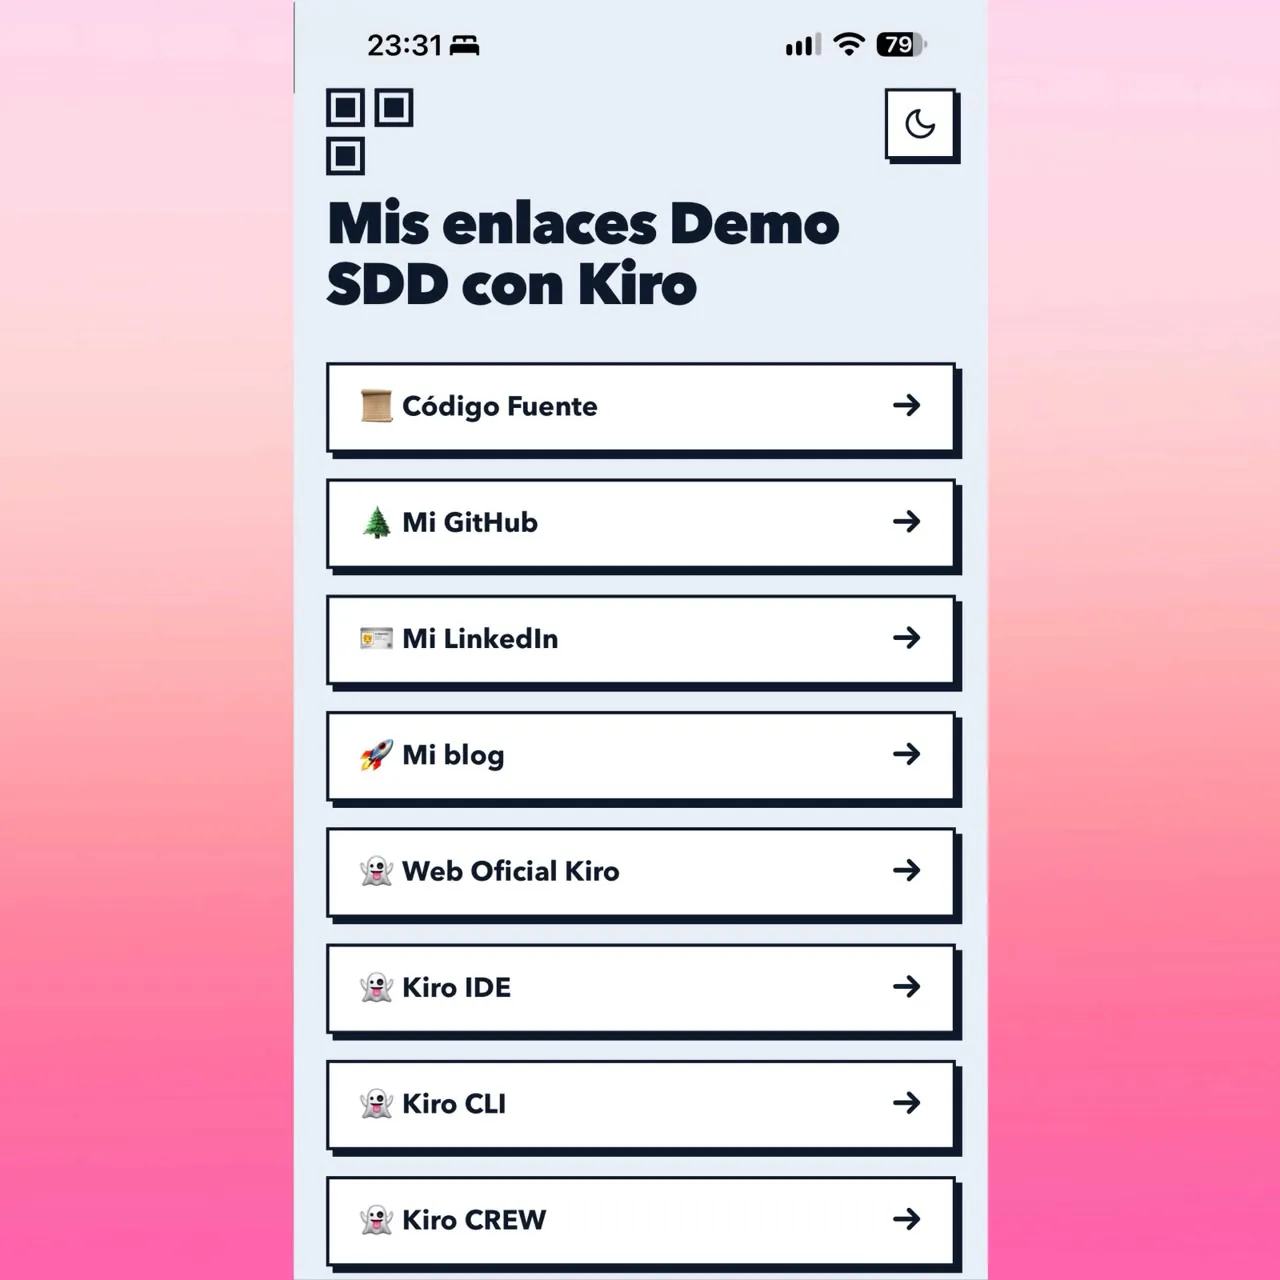
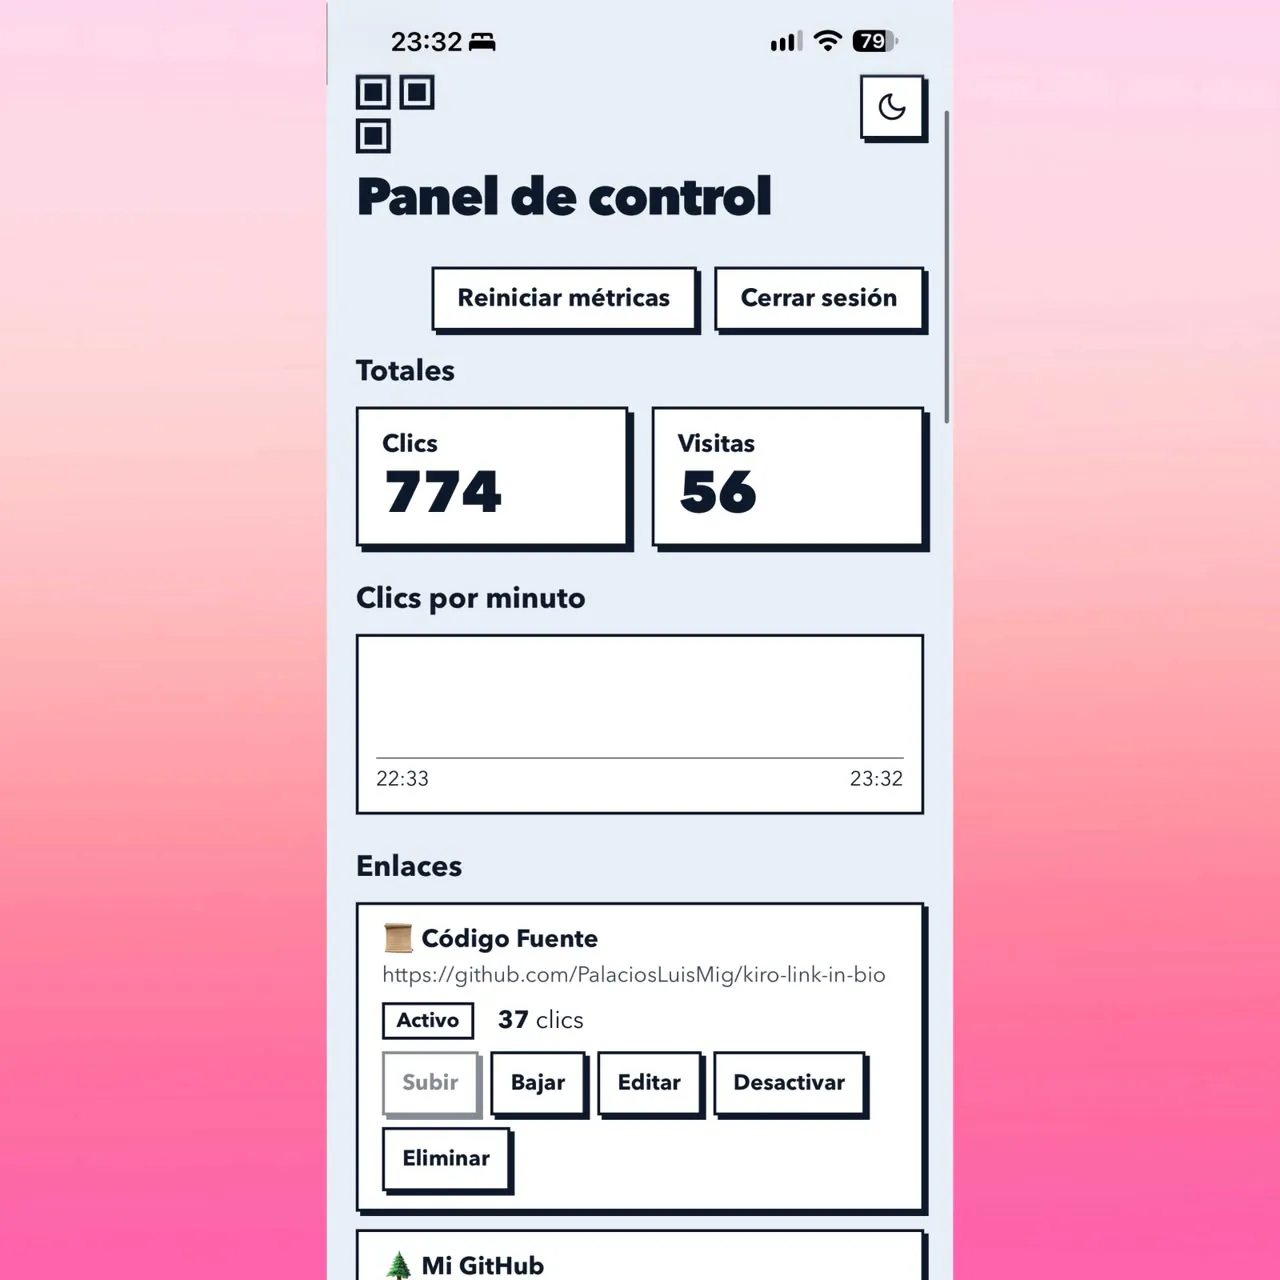
Para cerrar, la demo fue interactiva: el público escaneaba un código QR desde su celular, tocaba un enlace y veía subir los contadores del panel en vivo. Cada QR llevaba un canal distinto (?src=: qr, linkedin, github, instagram, tiktok), así que la tabla de canales de origen se iba repartiendo según la zona del aula.
¿Vibe coding o specs?
No es uno contra otro:
| Vibe coding | Spec-Driven | |
|---|---|---|
| Ideal para | Prototipos, hackathons, scripts | Productos, equipos, producción |
| Velocidad inicial | ⚡ Muy alta | Media |
| Mantenimiento | Difícil | Predecible |
| Decisiones | En la cabeza (o en el chat) | Escritas en el repo |
| Calidad | “Parece que funciona” | Requisitos verificables + tests |
Vibe coding para descubrir, specs para construir. Si mañana tienes un hackathon de 24 horas, vibe coding. Si es tu tesis, un proyecto para un cliente o algo que otra persona va a mantener, specs. Combinarlos también vale: prototipa para descubrir qué quieres y luego escribe la spec con lo aprendido.
Replica la demo
El repositorio está pensado como material de estudio: github.com/PalaciosLuisMig/kiro-link-in-bio. Cada fase tiene su rama y su guía en docs/ con “Cómo reproducir esta fase”.
# Ejemplo: replicar la fase 2
git clone https://github.com/PalaciosLuisMig/kiro-link-in-bio.git
git switch -c fase-2-design origin/fase-1-requirements
# ...trabaja con Kiro...
git diff fase-2-design origin/fase-2-design -- .kiro/
Lo que más me llevo
- ✅ Un aula llena de estudiantes con muchas ganas de aprender y construir.
- ✅ Preguntas muy buenas sobre cómo usar IA sin perder criterio de ingeniería. Esa es justo la pregunta que importa: la IA acelera, pero el criterio sigue siendo nuestro.
- ✅ Compartir espacio con otros ponentes de la comunidad AWS.
Gracias al AWS Student Builder Group de la Universidad de Cuenca por la invitación y la organización, y a todos los que se quedaron a la charla. ¡Seguimos construyendo comunidad! ☁️